이 글은 48GB 맥미니에서 LM Studio를 운영하며 로컬 모델을 필요할 때만 사용하고 작업이 끝나면 자동으로 내리는 방법을 다룬다. LM Studio 서버가 구동 중이고, ~/.lmstudio/bin/lms CLI가 PATH에 등록되어 있거나 전체 경로로 접근할 수 있다는 전제 아래서 진행된다.
LM Studio JIT 로딩 기본 동작 확인하기
LM Studio 서버는 포트 1234에서 OpenAI 호환 API를 제공한다. 이곳으로 모델 이름을 지정해 요청을 보내면, 필요한 모델을 그때그때 로드하는 JIT(Just-In-Time) 방식이 기본이다. 이 덕분에 여러 모델을 번갈아 쓰더라도 메모리에 상주시키는 부담이 적다.
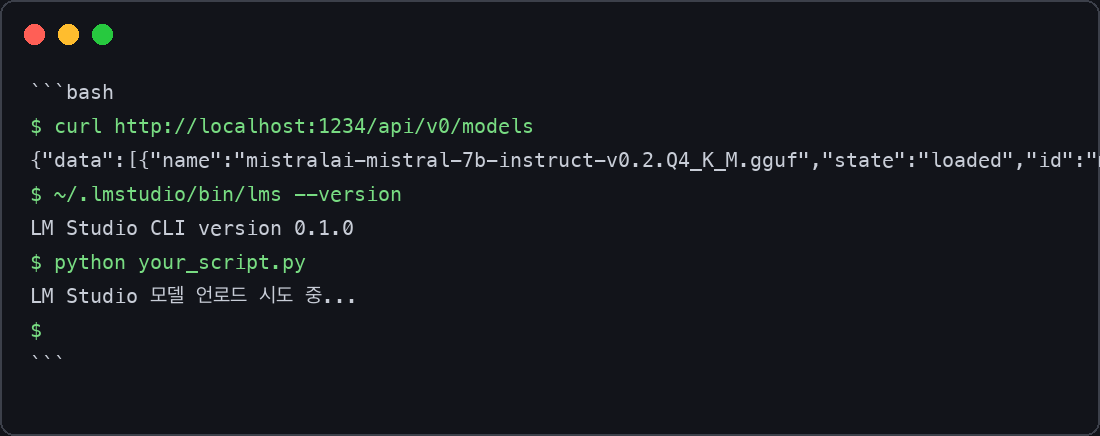
현재 LM Studio에 어떤 모델이 로드되어 있는지 확인하려면 다음 curl 명령어를 사용한다.
curl http://localhost:1234/api/v0/models확인 방법: 이 명령을 실행하면 현재 LM Studio가 인식하는 모델 목록과 함께 state 정보를 볼 수 있다. 모델이 로드된 상태라면 state: "loaded"로 나타난다.
LM Studio CLI 활용 자동 언로드 파이프라인 구축하기
작업이 끝나면 자동으로 모델을 내리도록 파이프라인을 구축하는 과정이다. LM Studio CLI 도구인 lms를 활용하여 자동 언로드를 구현한다.
먼저, lms CLI가 제대로 동작하는지 확인한다.
~/.lmstudio/bin/lms --version확인 방법: 정상적으로 버전 정보가 출력되면 CLI가 제대로 동작하는 것이다.
우리 자동화 파이프라인은 주로 파이썬 스크립트로 작동한다. 특정 조사 작업이 끝나면 항상 모델을 내리도록 스크립트의 마지막 단계에 lms unload --all 명령어를 추가하는 방식이다. 아래는 모델 로드 상태를 확인한 뒤에 언로드하는 파이썬 스크립트 예시다.
import subprocess
import json

# ... (이전 작업 로직) ...

def is_model_loaded():
    """현재 LM Studio에 로드된 모델이 있는지 확인한다."""
    try:
        result = subprocess.run(
            ['curl', '-s', 'http://localhost:1234/api/v0/models'],
            capture_output=True, text=True, check=True
        )
        models_info = json.loads(result.stdout)
        for model in models_info.get('data', []):
            if model.get('state') == 'loaded':
                return True
        return False
    except (subprocess.CalledProcessError, json.JSONDecodeError):
        return False

# 현재 모델 로드 상태를 확인하여 언로드 여부 결정
if is_model_loaded():
    # 모델이 로드된 경우에만 언로드 실행
    # 실제 환경에서는 특정 작업 중인지 아닌지 플래그 등으로 더 세밀하게 제어한다.
    print("LM Studio 모델 언로드 시도 중...")
    try:
        subprocess.run(['~/.lmstudio/bin/lms', 'unload', '--all'], check=True)
        print("모든 LM Studio 모델이 언로드되었습니다.")
    except subprocess.CalledProcessError as e:
        print(f"LM Studio 모델 언로드 실패: {e}")
else:
    print("로드된 LM Studio 모델이 없어 언로드할 필요가 없습니다.")

# ... (이후 작업 로직 또는 종료) ...
이 스크립트 예시처럼 curl로 모델 로드 상태를 확인한 뒤에 lms unload --all을 실행하는 로직을 넣는다. 중요한 점은, 활성 상태인 작업이 진행 중일 때는 이 언로드 단계를 건너뛰어야 한다는 것이다. 필자는 별도의 상태 파일을 두어 현재 어떤 종류의 작업이 진행 중인지 플래그로 관리하고, 언로드 스크립트 실행 전에 이 플래그를 확인한다.
확인 방법: 스크립트 실행 후 "모든 LM Studio 모델이 언로드되었습니다." 메시지가 출력되는지 확인한다.
동시 작업 메모리 경합 문제 해결하기
48GB 맥미니에서 여러 자동화 파이프라인을 돌리다 보면 메모리 경합 문제가 자주 불거진다. 특히 같은 35B 모델의 변형 두 가지를 각각의 파이프라인이 동시에 쓸 때 문제가 심각했다. 첫 번째 파이프라인이 모델을 로드한 상태에서, 두 번째 파이프라인이 다른 변형 모델을 로드하려 하면 48GB 메모리로는 부족했다. 그 결과 두 번째 로드가 메모리 부족으로 취소되거나, 심지어 돌던 첫 번째 모델이 강제로 unloaded 상태로 끊기는 현상이 발생했다.
이 문제의 해결책은 크게 두 가지였다.
- 모델 ID 통일: 가능하면 동일한 베이스 모델의 여러 변형을 쓰지 않고, 가장 범용적인 모델 하나만 선택해 모든 파이프라인에서 해당 모델 ID로 통일한다.
- 작업 전 선제적 언로드: 만약 다른 모델을 써야만 한다면, 새로운 모델을 로드하기 전에
lms unload --all명령으로 현재 로드된 모든 모델을 미리 내리고 시작하는 방식을 택한다. 이는 지연 시간은 조금 늘지만 안정성을 높여준다.
필자의 경우엔 후자의 방식을 주로 사용한다. 파이프라인 시작 시점에 혹시 모를 로드된 모델을 정리하고, 필요한 모델을 새로 로드하는 식이다.
확인 방법: 여러 파이프라인을 동시에 실행했을 때 메모리 부족으로 인한 모델 로드 실패나 강제 언로드 현상이 감소했는지 확인한다.
모델별 토큰 사용량에 맞는 자원 관리하기
모델을 쓸 때 max_tokens 설정도 중요하다. 특히 추론 능력이 뛰어난 '사고형 모델'은 한 줄짜리 단순한 질문에도 내부적으로 2천에서 4천 토큰을 사용해 추론 과정을 거친다. 이런 모델에 max_tokens를 너무 적게 주면 원하는 답변을 온전히 받지 못하거나, 불필요하게 모델을 여러 번 호출하게 될 수 있다.
경험상 max_tokens는 최소 8000 정도로 넉넉하게 주는 것이 좋았다. 더불어 간단한 요약이나 형식 변환 같은 '잔일'은 Gemma-4-E4B처럼 작고 빠른 비사고형 모델(예: reasoning_effort: none 설정)로 분리해 쓰는 것이 전체 자원 활용 면에서 효율적이었다. 비사고형 모델은 사고형 모델보다 훨씬 적은 토큰과 시간으로 단순 작업을 처리할 수 있다.
로컬 LLM을 효과적으로 활용하려면, 작업의 성격에 맞춰 사고형/비사고형 모델을 구분하고 max_tokens를 최적화하는 것이 중요하다.
확인 방법: 모델의 응답이 불완전하지 않고, 자원(메모리/CPU) 사용량이 작업 유형에 맞게 효율적으로 분배되는지 모니터링한다.
LM Studio GUI 수동 로딩 시 주의할 점
LM Studio GUI에서 모델을 수동으로 '로드' 버튼을 눌러 올리면 상황이 달라진다. 분명히 JIT 로딩이 기본인데도, GUI로 올려둔 모델은 종료 타이머가 붙지 않았다. 필자 역시 26GB짜리 모델 하나가 며칠 동안 맥미니 메모리를 점유하고 있는 걸 뒤늦게 발견했다. 작업도 없는데 텅 빈 메모리 26GB를 보고 있자니 답답했다. 해당 모델을 GUI에서 직접 '언로드'하고 나니 그때부터 JIT 로딩이 정상적으로 작동하는 것을 확인했다.
이 경험 덕분에 수동으로 모델을 올리는 일은 최소화하기로 했다. GUI를 통해 모델을 로드할 경우, 사용 후에는 반드시 수동으로 '언로드'해야 불필요한 메모리 점유를 막을 수 있다. 그렇지 않으면 자칫 메모리 부족 현상으로 이어질 수 있다.
로컬 모델의 메모리 관리는 자원이 한정된 개인 환경에서 특히 중요하다. JIT 로딩을 적극 활용하고, 불필요한 메모리 점유를 막는 자동화 스크립트를 적용하면 48GB 맥미니로도 꽤 다양한 작업을 소화할 수 있었다.