블로그에 글을 올리는 일은 손이 많이 간다. 제목 넣고, 본문 붙이고, 카테고리 고르고, 태그 치고, 이미지 올리고, 발행 누른다. 한 편이면 괜찮은데 매일 하면 지겹다.
공개 API가 있으면 그걸 쓰는 게 맞다. 없거나 막혀 있으면 남는 방법은 하나다. 브라우저를 대신 움직이는 것이다.
우리는 이 방식으로 매일 글을 올린다. 이 글은 그 구조와, 실제로 굴려보고 알게 된 함정들이다.
무엇을 쓰나
Playwright를 쓴다. 브라우저를 코드로 조종하는 도구다. 파이썬으로 쓴다면 이렇게 깐다.
pip install playwright
playwright install chromium
두 번째 줄이 브라우저 자체를 받는 것이다. 내 컴퓨터에 깔린 크롬과 별개로 전용 브라우저를 쓴다.
로그인은 한 번만
제일 먼저 부딪히는 문제가 로그인이다. 매번 아이디와 비밀번호를 넣게 만들면 안 된다. 위험하기도 하고 2단계 인증에서 막힌다.
전용 프로필 폴더를 쓴다. 사람이 한 번 로그인해두면 그 폴더에 쿠키가 남고, 다음부터는 로그인 상태로 시작한다.
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    ctx = p.chromium.launch_persistent_context(
        "./browser-profile",          # 이 폴더에 로그인 상태가 남는다
        headless=False,
        viewport={"width": 1400, "height": 900},
    )
    page = ctx.pages[0]
    page.goto("https://내블로그/manage/newpost/")
headless=False가 중요하다. 화면 없는 모드로 띄우면 로그인 서비스가 새 기기로 취급해서 추가 인증을 요구한다. 우리도 이걸로 막혔다. 창이 뜨는 게 거슬려도 이쪽이 결국 빠르다.
화면 요소는 추측하지 말 것
여기서 시간을 제일 많이 버린다.
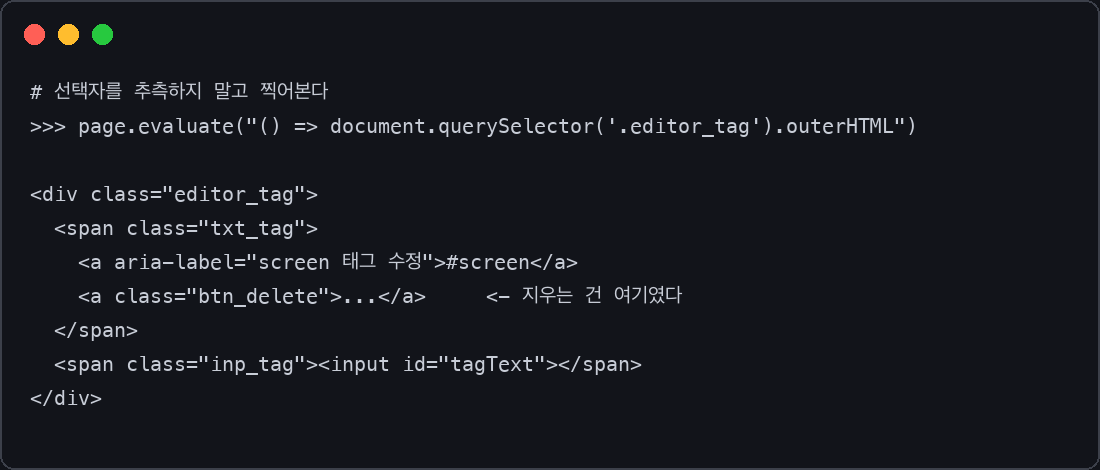
제목 칸, 태그 칸, 발행 버튼을 코드로 찾아야 하는데, 이름을 짐작해서 쓰면 대개 틀린다. 우리는 태그 지우는 기능을 만들면서 두 번 헛짚었다. tag_list라는 이름을 뒤졌는데 실제로는 editor_tag였다. 두 번 다 아무것도 안 지워졌고, 왜 안 되는지 한참 봤다.
브라우저를 열어서 직접 찍어보는 데 5분이면 된다. 이렇게 구조를 그대로 뽑아볼 수 있다.
html = page.evaluate("() => document.querySelector('.어떤영역').outerHTML")
print(html[:2000])
그걸 보고 나면 선택자가 한 번에 맞는다. 추측으로 세 번 고치는 것보다 짧다.
기다리는 방법이 중요하다
고정 시간으로 기다리면 안 된다. 3초 쉬고 다음 줄로 가는 식은 느린 날 깨지고 빠른 날 시간을 버린다.
요소가 나타날 때까지 기다리게 한다.
page.wait_for_selector("#tagText", state="attached", timeout=60_000)
state를 뭘로 주느냐도 갈린다. 화면에 보이는지(visible)로 기다리면 실패하는 경우가 있다. 글이 길어서 그 칸이 화면 아래에 있으면 붙어 있어도 안 보인다. attached로 두고 필요하면 직접 스크롤해서 끌어오는 쪽이 안전하다.
실제로 겪은 함정들
입력칸이 사라지는 경우가 있다. 태그는 열 개가 상한인데, 열 개가 차면 플랫폼이 입력칸을 화면에서 아예 빼버린다. 입력칸이 나타나기를 기다리는 코드는 그때 영원히 멈춘다. 순서를 바꿔서 먼저 지우고 그다음에 입력칸을 잡아야 한다.
저장이 늦는 날이 있다. 평소에는 몇 초면 끝나는데 어떤 날은 응답이 한참 없다. 20초에 포기하게 해뒀더니 사람이 계속 다시 돌려야 했다. 넉넉히 기다리게 바꿨다.
기존 글을 고칠 때는 주소를 확인한다. 새 글 쓰기 화면과 기존 글 고치기 화면은 주소가 다르다. 잘못 들어가면 고치려던 게 새 글로 올라간다. 되돌리기 번거로우니 처음부터 맞게 들어가야 한다.
캡차는 자동으로 풀지 않는다
가끔 사람인지 확인하는 창이 뜬다. 지도가 나오고 빈칸을 채우라는 식이다.
이건 사람이 푼다. 코드로 풀지 않는다.
기술적으로 못 하는 게 아니라 하면 안 되는 것이다. 캡차는 자동화를 걸러내려고 있는 장치이고, 그걸 우회하면 서비스 입장에서는 계정을 막을 이유가 된다. 블로그 계정이 막히면 그동안 쌓은 글이 다 위험해진다.
그래서 우리 코드는 캡차가 뜨면 창을 열어둔 채로 사람을 기다린다. 알림을 보내고, 사람이 와서 풀면 그대로 이어서 발행한다.
이 방식의 한계
- 사람이 반드시 한 번은 필요하다. 처음 로그인과 캡차
- 화면이 바뀌면 깨진다. 플랫폼이 에디터를 고치면 선택자를 다시 맞춰야 한다
- 창이 하나씩만 열린다. 프로필 폴더를 공유하니 동시에 두 개를 돌릴 수 없다. 순서대로 돌려야 한다
그래도 매일 하는 작업이라면 값어치가 있다. 우리는 이 구조로 열 편 넘는 글을 하루에 올렸다.
정리
1. launch_persistent_context로 로그인 상태를 폴더에 남긴다
2. headless=False. 화면 없는 모드는 추가 인증에 걸린다
3. 선택자는 열어서 찍어보고 쓴다. 추측은 두 배로 돌아온다
4. 고정 시간 대기 금지. attached로 기다리고 직접 스크롤한다
5. 캡차는 사람이 푼다
여기 나오는 코드와 함정은 실제로 굴리면서 하나씩 부딪힌 것들이다.
'콘텐츠 생산 및 자동화' 카테고리의 다른 글
| AI 보이스 기계음: pad, atempo 미세 조정으로 해결 (0) | 2026.09.06 |
|---|---|
| 쇼츠 자동화 파이프라인: 개발자용 템플릿 공개, 효율적 제작 검수 (0) | 2026.09.06 |
| AI 허브 977개 무료 데이터, 검색으로 보물찾기 성공 (0) | 2026.09.05 |
| Whisper로 영상 자막 자동 생성하기, 맥에서 무료로 (0) | 2026.08.31 |
| 쇼츠 대본 AI로 뽑기, 잘 되는 채널 대본부터 뜯어보고 배운 것 (0) | 2026.08.31 |