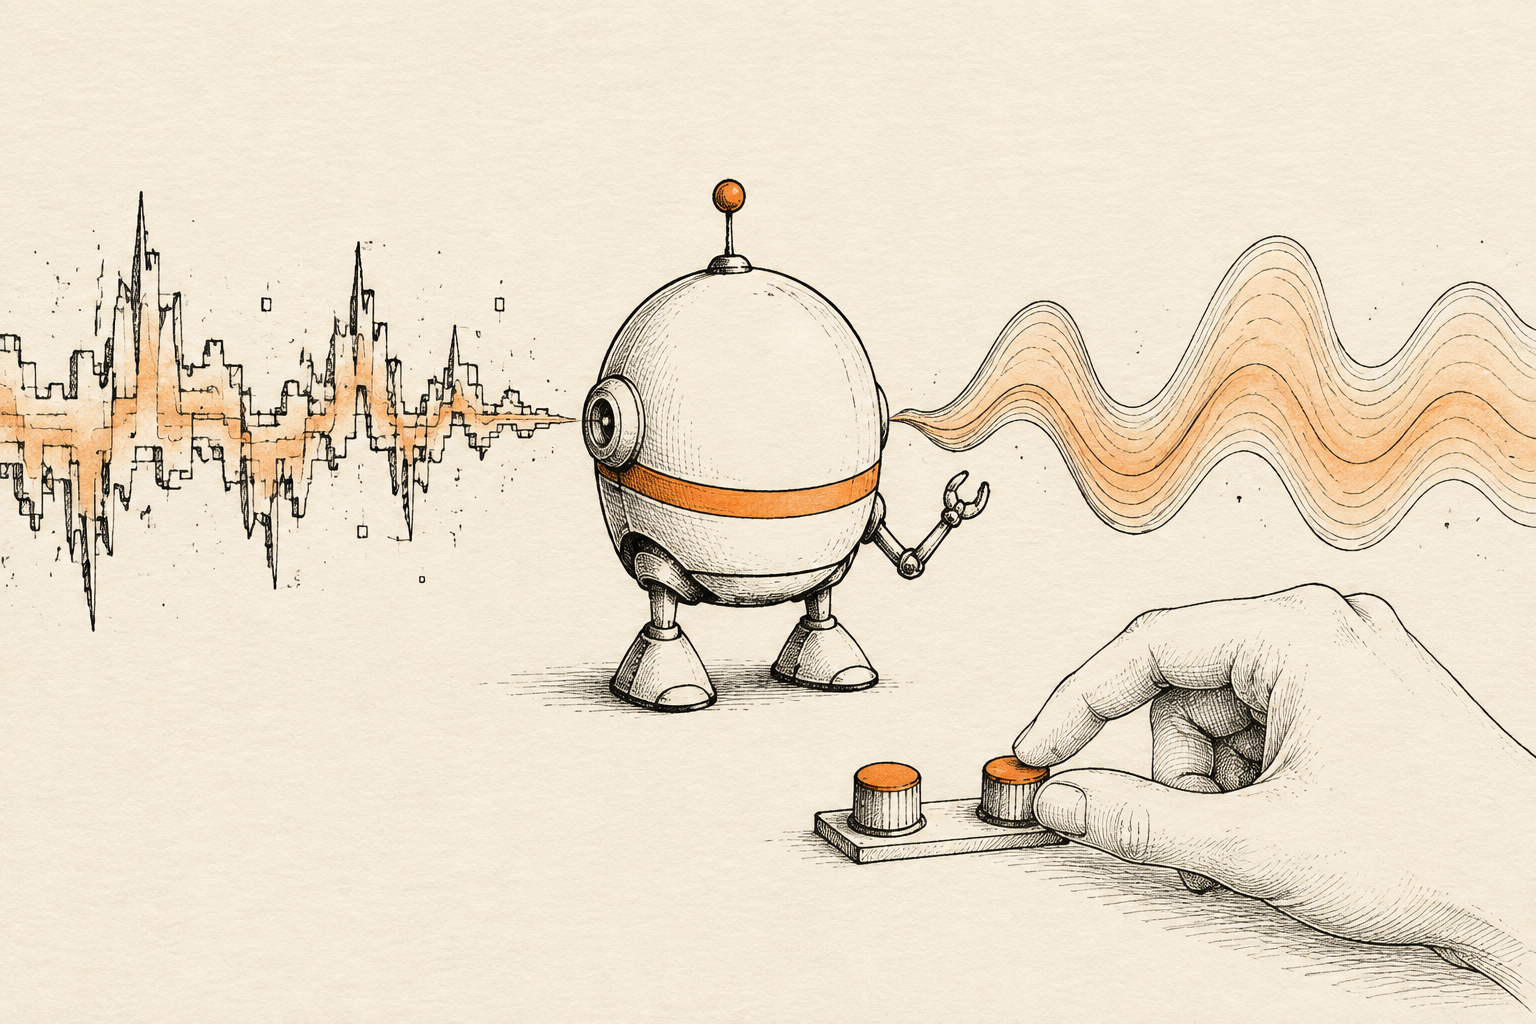
유튜브 쇼츠 AI 보이스는 결국 두 가지 축으로 수렴했다. pad와 atempo, 딱 이 두 가지였다.
우리 쇼츠 콘텐츠에 "불쾌한 AI 보이스오버"라는 시청자 댓글이 달렸을 때, 정신이 번쩍 들었다. 나도 모르게 기계적인 목소리를 만들고 있었던 거다.
이걸 해결하려고 쉼과 속도 변주를 다섯 버전(v3부터 v7까지)에 걸쳐 끈질기게 실험했다. 처음엔 TTS 엔진의 내부 파라미터를 건드렸다. Kokoro 같은 엔진의 speed 인자는 1.14와 1.18을 줬을 때 출력 길이를 재보니 완전히 똑같았다.
짧은 문장에선 내부 로직이 속도 조절을 뭉개버리는 것 같았다. 결국 TTS 자체의 속도 변주는 포기하고, 후처리 단계에서 ffmpeg atempo 필터로 속도를 조절하는 쪽으로 가닥을 잡았다.
ffmpeg -i input.wav -filter_complex "atempo=0.9" output.wav
더 골치 아픈 건 쉼이었다. 무음 구간을 처음 실측했을 때, 0.12초에서 0.38초 사이에 쉼이 몰려 있는 걸 보고 소름이 돋았다. 기계적인 박자가 너무 선명했다.
규칙 기반으로 구두점마다 쉼을 넣는 것도 해봤는데, 결과는 처참했다. "forty percent of, your"처럼 엉뚱한 곳에서 문장을 잘랐다.
더 나아가 의미 단위, 그러니까 절 단위로 잘라 붙이면 어떨까도 생각했다. 문장마다 F0 값(목소리의 기본 주파수)을 리셋해서 억양 곡선을 새로 그리는 방식인데, 이렇게 했더니 한 문장이 두 문장처럼 들리는 부작용이 생겼다.
대본 생성 단계에서 의미를 부여하는 건 필수지만, 그 이후 보이스 후처리에서는 통하지 않았다. 내 경험으로는 말의 여운은 절대적인 침묵의 길이보다 직전 발화와의 대비에서 온다는 걸 깨달았다.
그래서 보이스가 끝나면 pad 필터로 침묵을 넣되, 강조해야 할 '결정타' 부분은 오히려 원래 속도로 끊어 여운을 강조하는 원칙을 세웠다.
수십 시간을 갈아 넣고 나서야 이런 단순한 결론에 도달했다. 복잡한 AI 모델 내부를 파고들기보다, 결국은 원시적인 오디오 처리, 그러니까 소리와 소리 사이의 공백(pad)과 재생 속도(atempo)를 섬세하게 조절하는 게 핵심이었다.
때로는 가장 기본적인 도구가 가장 강력한 해결책이 된다.
'콘텐츠 생산 및 자동화' 카테고리의 다른 글
| 내 목소리로 말하는 AI 만들기, 녹음 17초면 됩니다 (0) | 2026.09.10 |
|---|---|
| AI 더빙으로 영상에 목소리 입히기, 내 컴퓨터에서 무료로 (0) | 2026.09.06 |
| 쇼츠 자동화 파이프라인: 개발자용 템플릿 공개, 효율적 제작 검수 (0) | 2026.09.06 |
| AI 허브 977개 무료 데이터, 검색으로 보물찾기 성공 (0) | 2026.09.05 |
| 블로그 글 자동 발행 만들기, 브라우저를 대신 움직이는 방법 (0) | 2026.09.03 |