영상에 목소리를 넣어야 하는데 내 목소리로 녹음하기는 부담스럽다. 발음이 신경 쓰이고, 한 번 틀리면 다시 읽어야 하고, 수정할 때마다 또 녹음해야 한다.
컴퓨터에 읽히면 된다. 돈도 안 들고 인터넷도 필요 없다. 다만 어떤 방법을 쓰느냐에 따라 결과가 많이 다르다. 두 가지를 같은 문장으로 만들어봤으니 들어보고 고르면 된다.
먼저 들어보기
같은 문장을 두 방법으로 읽혔다. "이번 편에서는 맥미니 한 대로 로컬 AI를 돌리면서 직접 잰 숫자를 그대로 보여드리겠습니다."
맥에 원래 들어 있는 목소리다. 설치할 것도, 받을 것도 없다.
짧은 녹음으로 복제한 목소리다. 만드는 법은 앞 글에 있다.
길이는 거의 같다. 6.5초와 6.4초다. 그런데 들어보면 차이가 있다.
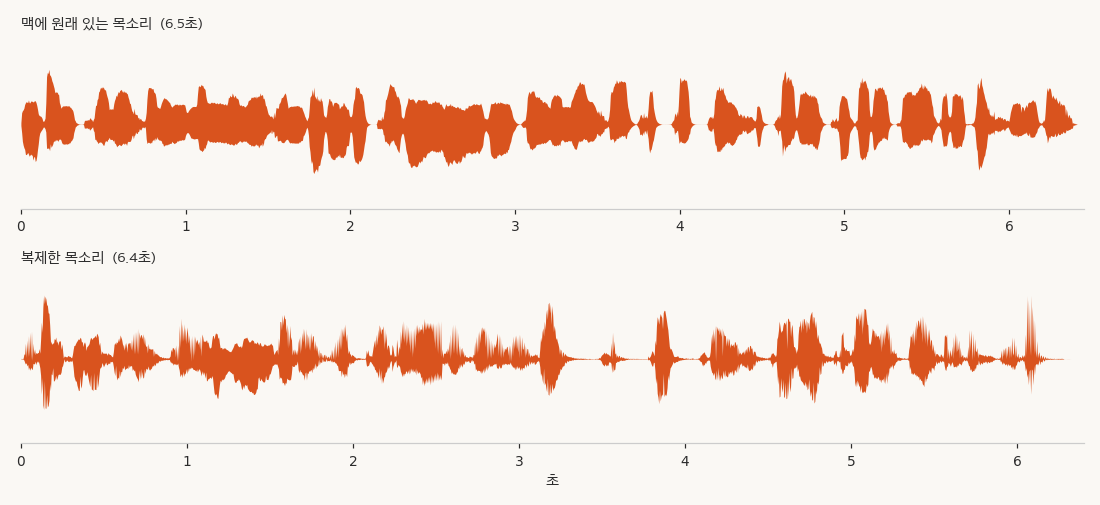
파형만 봐도 다르다. 위쪽은 소리 크기가 고르게 유지된다. 아래쪽은 세게 말하는 곳과 흘리는 곳이 갈린다. 사람은 말할 때 힘을 고르게 주지 않는다. 그 불균일함이 자연스러움으로 들린다.
공짜로 당장 되는 쪽부터
맥에는 목소리가 이미 들어 있다. 터미널에 한 줄이면 파일이 나온다.
say -v Yuna -o out.aiff "읽게 할 문장을 여기에 적는다"
한국어 목소리는 아홉 개가 들어 있다. 어떤 게 있는지는 이렇게 본다.
say -v '?' | grep ko_KR
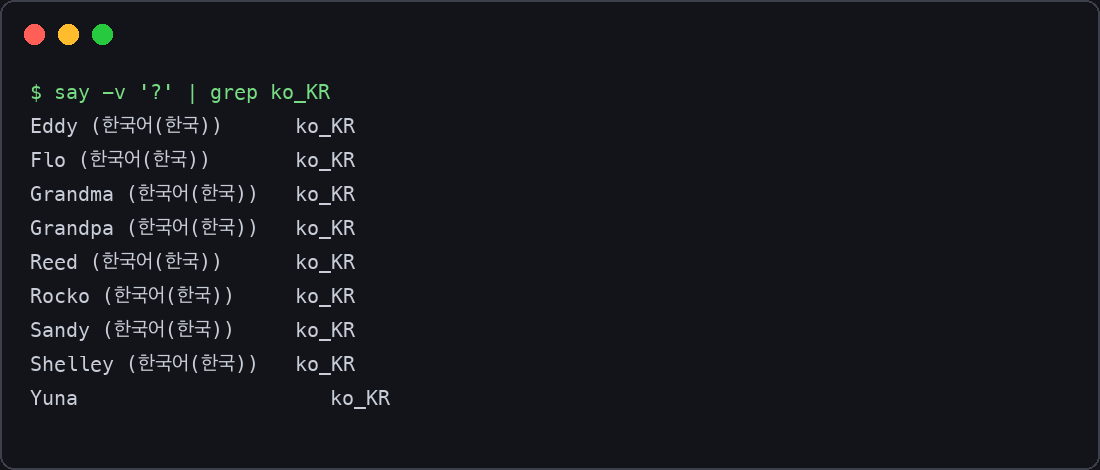
설치도 준비도 필요 없다. 자막 읽기, 짧은 안내, 시험 삼아 만드는 영상에는 이걸로 충분하다. 사람 목소리 같지는 않지만 알아듣는 데 문제가 없다.
나온 파일은 aiff라 영상 도구가 싫어할 수 있다. 한 줄로 바꾼다.
ffmpeg -i out.aiff -ar 24000 -ac 1 out.wav
더 자연스럽게 가려면
복제한 목소리를 쓰는 쪽이다. 짧은 녹음 하나로 만들 수 있고, 만드는 방법은 앞 글에 적었다. 내 목소리로 말하는 AI 만들기, 녹음 17초면 됩니다
여기서는 영상에 얹는 과정만 다룬다. 문장 하나 읽히는 것과 영상 하나를 더빙하는 것은 다른 일이다.
1. 대본을 문단으로 쪼갠다
가장 흔한 실수가 대본 전체를 한 번에 넣는 것이다. 뒤로 갈수록 억양이 흔들리고 속도가 이상해진다.
빈 줄로 문단을 나누고 문단마다 따로 만든다. 우리는 이렇게 쓴다.
narration.txt   ← 빈 줄로 문단 구분
   ↓
narr_01.wav  narr_02.wav  narr_03.wav …
문단 하나가 두세 문장을 넘지 않게 한다. 틀린 문단만 다시 만들면 되니 고치기도 쉽다.
2. 사이에 쉼을 넣고 이어 붙인다
문단 파일을 그냥 붙이면 숨도 안 쉬고 읽는 소리가 된다. 사이에 짧은 무음을 넣어야 한다.
우리는 0.6초를 쓴다. 0.3초는 급하게 들리고, 1초를 넘기면 끊긴 느낌이 든다. 영상 흐름에 따라 조금씩 바꾸면 된다.
붙이는 것도 ffmpeg으로 된다. 파일 목록을 적어두고 한 번에 잇는다.
3. 영상에 얹는다
영상과 소리를 합친다.
ffmpeg -i video.mp4 -i narration.wav -c:v copy -c:a aac -shortest out.mp4
-c:v copy가 중요하다. 영상은 건드리지 않고 소리만 바꾼다는 뜻이라 순식간에 끝나고 화질도 안 떨어진다. 이걸 빼면 영상을 통째로 다시 만드느라 몇 분씩 걸린다.
-shortest는 둘 중 짧은 쪽에 맞춰 끝내라는 뜻이다. 소리가 영상보다 길면 뒤가 잘린다.
배경음악을 넣는다면
두 가지만 지키면 티가 안 난다.
- 한 곡을 처음부터 끝까지. 중간에 곡이 바뀌면 시청자가 그 순간을 알아챈다. 짧은 곡을 이어 붙이는 것도 마찬가지다
- 말할 때만 음악을 살짝 줄인다. 확 줄이면 부자연스럽다. 말이 묻히지 않을 만큼만 낮춘다
효과음을 합성으로 만들어 넣는 것은 권하지 않는다. 어색함이 바로 들린다.
자주 어긋나는 것
- 숫자를 이상하게 읽는다.
24시간을 "이십사"로 읽을지 "스물네"로 읽을지 도구가 정한다. 대본에 아예 한글로 적어두는 게 확실하다 - 영어를 그대로 읽는다. 도구 이름이나 약어는 한글 표기를 같이 정해두고 대본에 그 표기를 쓴다
- 속도가 마음에 안 든다. 복제 목소리는 참조 녹음의 속도를 따라간다. 천천히 읽은 녹음을 쓰면 천천히 말한다. 녹음을 바꾸는 게 설정을 만지는 것보다 빠르다
- 문단 하나만 튄다. 그 문단만 다시 만든다. 전체를 다시 돌릴 이유가 없다
얼마나 걸리나
맥미니에서 51자 문장 하나에 9.9초 걸렸다. 만들어진 소리는 6.4초다. 말하는 시간보다 만드는 시간이 조금 더 긴 정도다.
모델을 올리는 데 처음 한 번 27.9초가 든다. 그래서 문단마다 프로그램을 새로 켜면 안 된다. 한 번 올려두고 문단을 연달아 뽑아야 한다.
맥에 원래 있는 목소리는 기다릴 것도 없이 바로 나온다. 급할 때는 그쪽이 낫다.
다음 글
- 목소리 만드는 법부터: 내 목소리로 말하는 AI 만들기, 녹음 17초면 됩니다
- 도구를 고르는 기준: 한국어 TTS 무료로 쓰기, 웹 서비스와 설치형 뭐가 다른가
여기 나오는 소리와 숫자는 맥미니에서 실제로 만들고 재서 적은 것이다.
'콘텐츠 생산 및 자동화' 카테고리의 다른 글
| 한국어 TTS 무료로 쓰기, 내 컴퓨터와 웹 서비스 뭐가 다른가 (0) | 2026.09.11 |
|---|---|
| 내 목소리로 말하는 AI 만들기, 녹음 17초면 됩니다 (0) | 2026.09.10 |
| AI 보이스 기계음: pad, atempo 미세 조정으로 해결 (0) | 2026.09.06 |
| 쇼츠 자동화 파이프라인: 개발자용 템플릿 공개, 효율적 제작 검수 (0) | 2026.09.06 |
| AI 허브 977개 무료 데이터, 검색으로 보물찾기 성공 (0) | 2026.09.05 |