먼저 들어보시는 게 빠릅니다.
사람이 낸 소리가 아니다. 짧은 녹음 하나를 컴퓨터에 주고 만들어 낸 것이다. 녹음실도, 유료 서비스도, 인터넷 연결도 쓰지 않았다. 집에 있는 맥미니 한 대로 만들었다.
이 글은 그걸 어떻게 하는지 처음부터 적은 것이다. 마지막에 하면 안 되는 것도 적었다. 그쪽이 더 중요하다.
필요한 것은 세 가지
- 녹음할 기계. 폰이면 된다. 기본으로 깔린 녹음기 앱으로 충분하다
- 돌릴 컴퓨터. 우리는 맥미니를 썼다. 요즘 나온 맥이면 된다
- 모델. 무료로 받을 수 있다. 돈 드는 곳이 한 군데도 없다
1. 녹음하기
폰 녹음기를 켠다.
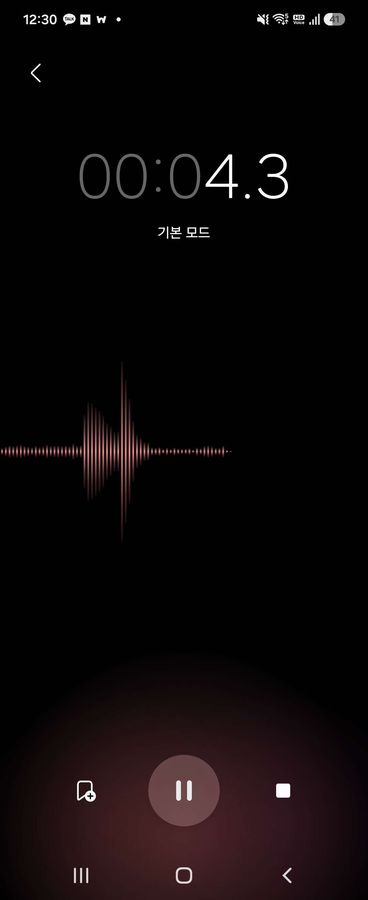
길게 할 필요가 없다. 우리가 쓴 녹음은 17초짜리다. 십몇 초에서 삼십 초 사이면 충분하고, 그보다 길게 넣는다고 더 좋아지지 않는다.
읽을 내용은 아무거나 좋지만 몇 가지를 지키면 결과가 확 달라진다.
- 조용한 곳에서. 에어컨 소리, 키보드 소리가 섞이면 그 소리까지 흉내 낸다
- 평소 말하듯이. 뉴스 앵커처럼 읽으면 뉴스 앵커 같은 목소리가 나온다
- 한 호흡으로 자연스럽게. 중간에 끊고 다시 시작한 녹음은 피한다
- 또박또박. 웅얼거리면 발음이 뭉개진 채로 복제된다
녹음이 끝나면 파일을 컴퓨터로 옮긴다.
여기서 한 가지 중요한 게 있다. 녹음한 내용을 글자로도 적어둬야 한다. 무슨 말을 했는지 컴퓨터에 같이 알려줘야 하기 때문이다. 소리만 주는 것보다 결과가 눈에 띄게 좋아진다.
2. 준비하기
파이썬이 깔려 있어야 한다. 맥에는 보통 있다.
작업 폴더를 만들고 그 안에만 설치한다. 이렇게 하면 다른 파이썬 작업이랑 엉키지 않는다.
처음 돌릴 때 모델을 내려받는다. 몇 기가바이트라 시간이 좀 걸린다. 한 번만 받으면 그 뒤로는 인터넷 없이 돌아간다.
3. 문장 넣고 뽑기
준비한 것은 세 개다. 녹음 파일, 그 녹음에서 말한 내용, 그리고 새로 말하게 할 문장.
from voxcpm import VoxCPM

m = VoxCPM.from_pretrained("openbmb/VoxCPM2", load_denoiser=False)

wav = m.generate(
    text="새로 말하게 할 문장을 여기에 적는다.",
    prompt_wav_path="내_녹음.wav",
    prompt_text="녹음에서 실제로 말한 내용을 그대로 적는다.",
)
prompt_text가 아까 말한 그 글자다. 녹음 내용과 다르게 적으면 결과가 나빠진다. 토씨까지 맞출 필요는 없지만 문장은 맞아야 한다.
얼마나 걸리나
맥미니에서 실제로 재본 값이다.
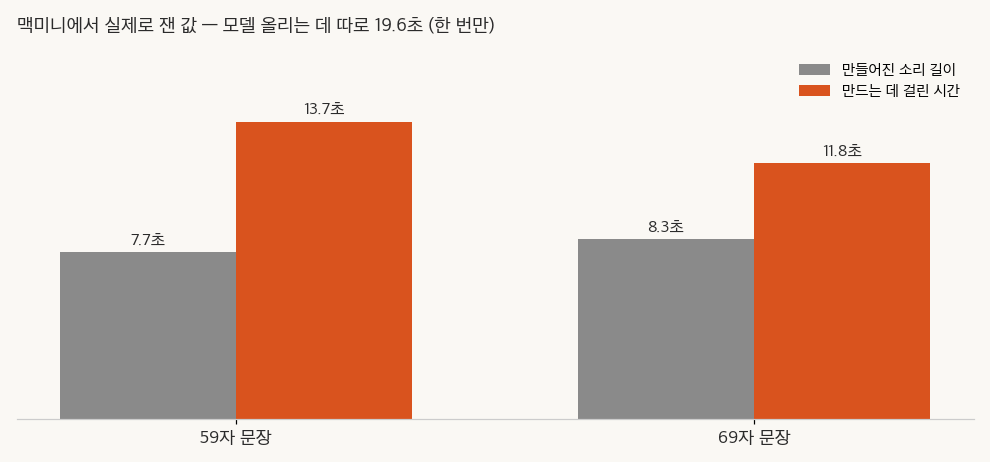
모델을 올리는 데 한 번 시간이 들고, 그 뒤로는 문장 길이에 비례한다. 한 번 올려두고 여러 문장을 연달아 뽑는 게 훨씬 빠르다. 문장 하나마다 프로그램을 새로 켜면 매번 그 시간을 다시 쓴다.
원본과 복제, 눈으로 보기
소리를 글로 설명하기는 어려우니 그림으로 본다. 위가 원래 녹음, 아래가 만들어 낸 소리다.
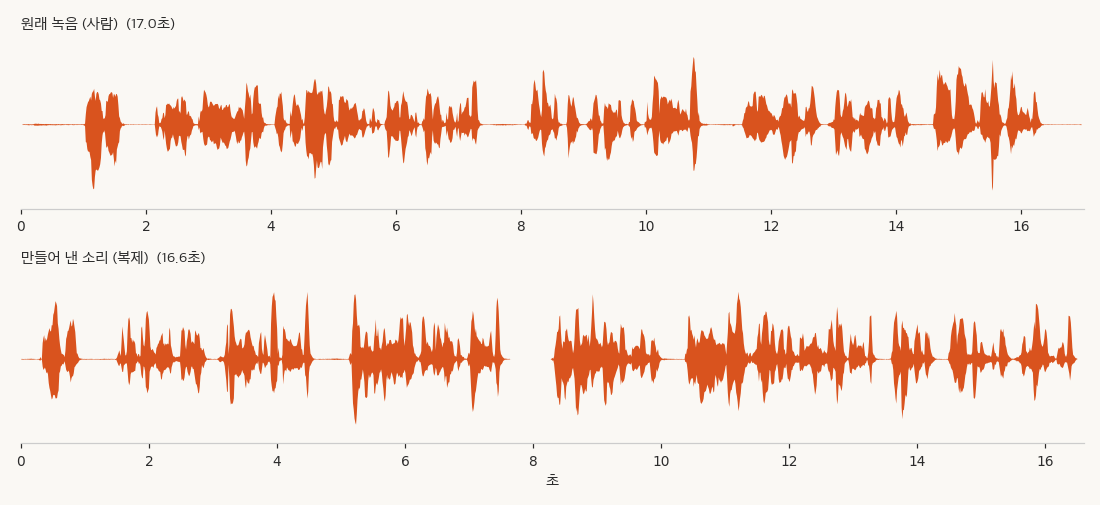
말의 높낮이와 끊는 자리가 비슷하게 따라간다. 다만 완전히 똑같지는 않다. 숨소리나 아주 미세한 떨림은 덜 살아난다. 아는 사람이 들으면 알아채는 경우가 많다.
잘 안 될 때
- 발음이 뭉개진다. 녹음이 웅얼거렸거나 잡음이 섞였다. 다시 녹음하는 게 빠르다
python3 -m venv voice-venv
voice-venv/bin/pip install voxcpm
- 말이 너무 빠르거나 느리다. 참조 녹음의 속도를 그대로 따라간다. 천천히 읽은 녹음을 쓰면 천천히 말한다
- 엉뚱한 억양이 나온다. 문장이 너무 길면 뒤로 갈수록 흔들린다. 문장을 짧게 끊어 여러 번 뽑고 이어 붙이는 게 낫다
- 숫자나 영어를 이상하게 읽는다. 한글로 바꿔 적으면 해결된다.
24시간보다스물네 시간이 안전하다
하면 안 되는 것
여기가 이 글에서 제일 중요한 부분이다.
남의 목소리를 허락 없이 복제하면 안 된다. 기술적으로 되는 것과 해도 되는 것은 다르다. 가족이나 친구 목소리도 마찬가지다. 장난으로 만든 음성 하나가 사기에 쓰이면 그건 장난이 아니게 된다.
실제로 이 기술은 보이스피싱에 쓰이고 있다. 자녀 목소리를 흉내 낸 전화가 대표적이다. 십몇 초면 충분하다는 것이 이 글의 요지인데, 그 십몇 초는 누구나 SNS에서 구할 수 있는 길이이기도 하다.
그래서 두 가지를 권한다.
- 내 목소리 녹음을 아무 데나 올리지 말 것. 긴 음성이 공개되어 있으면 재료를 넘겨주는 셈이다
- 만든 음성에는 만들었다고 밝힐 것. 영상이든 글이든 표시를 남긴다
이 글에 붙인 소리도 그래서 짧고, 스스로 복제음이라고 말하는 내용이다.
다음 글
- 영상에 입히려면: AI 더빙으로 영상에 목소리 입히기, 내 컴퓨터에서 무료로
- 목소리를 고르고 싶다면: 한국어 TTS 무료로 쓰기, 웹 서비스와 설치형 뭐가 다른가
여기 나오는 시간과 파형은 맥미니에서 실제로 돌려 재고 그린 값이다.
'콘텐츠 생산 및 자동화' 카테고리의 다른 글
| 유튜브 AI 표시, 어디까지 해야 하나 (0) | 2026.09.11 |
|---|---|
| 한국어 TTS 무료로 쓰기, 내 컴퓨터와 웹 서비스 뭐가 다른가 (0) | 2026.09.11 |
| AI 더빙으로 영상에 목소리 입히기, 내 컴퓨터에서 무료로 (0) | 2026.09.06 |
| AI 보이스 기계음: pad, atempo 미세 조정으로 해결 (0) | 2026.09.06 |
| 쇼츠 자동화 파이프라인: 개발자용 템플릿 공개, 효율적 제작 검수 (0) | 2026.09.06 |